파이썬 스크립트
사용자 정의 파이썬 스크립트를 실행합니다.
입력 포트
데이터셋
출력 포트
데이터셋: 파이썬 스크립트가 실행된 데이터셋
설명
파이썬 스크립트 노드는 사용자가 직접 작성한 Python 코드를 실행하여 데이터를 처리할 수 있습니다.
전처리 노드로 표현하기 어려운 사용자 정의 로직(복잡한 변환, 통계 계산, 외부 DB 조회, 문서 파일 생성 등)을 직접 코드로 작성할 때 사용합니다.
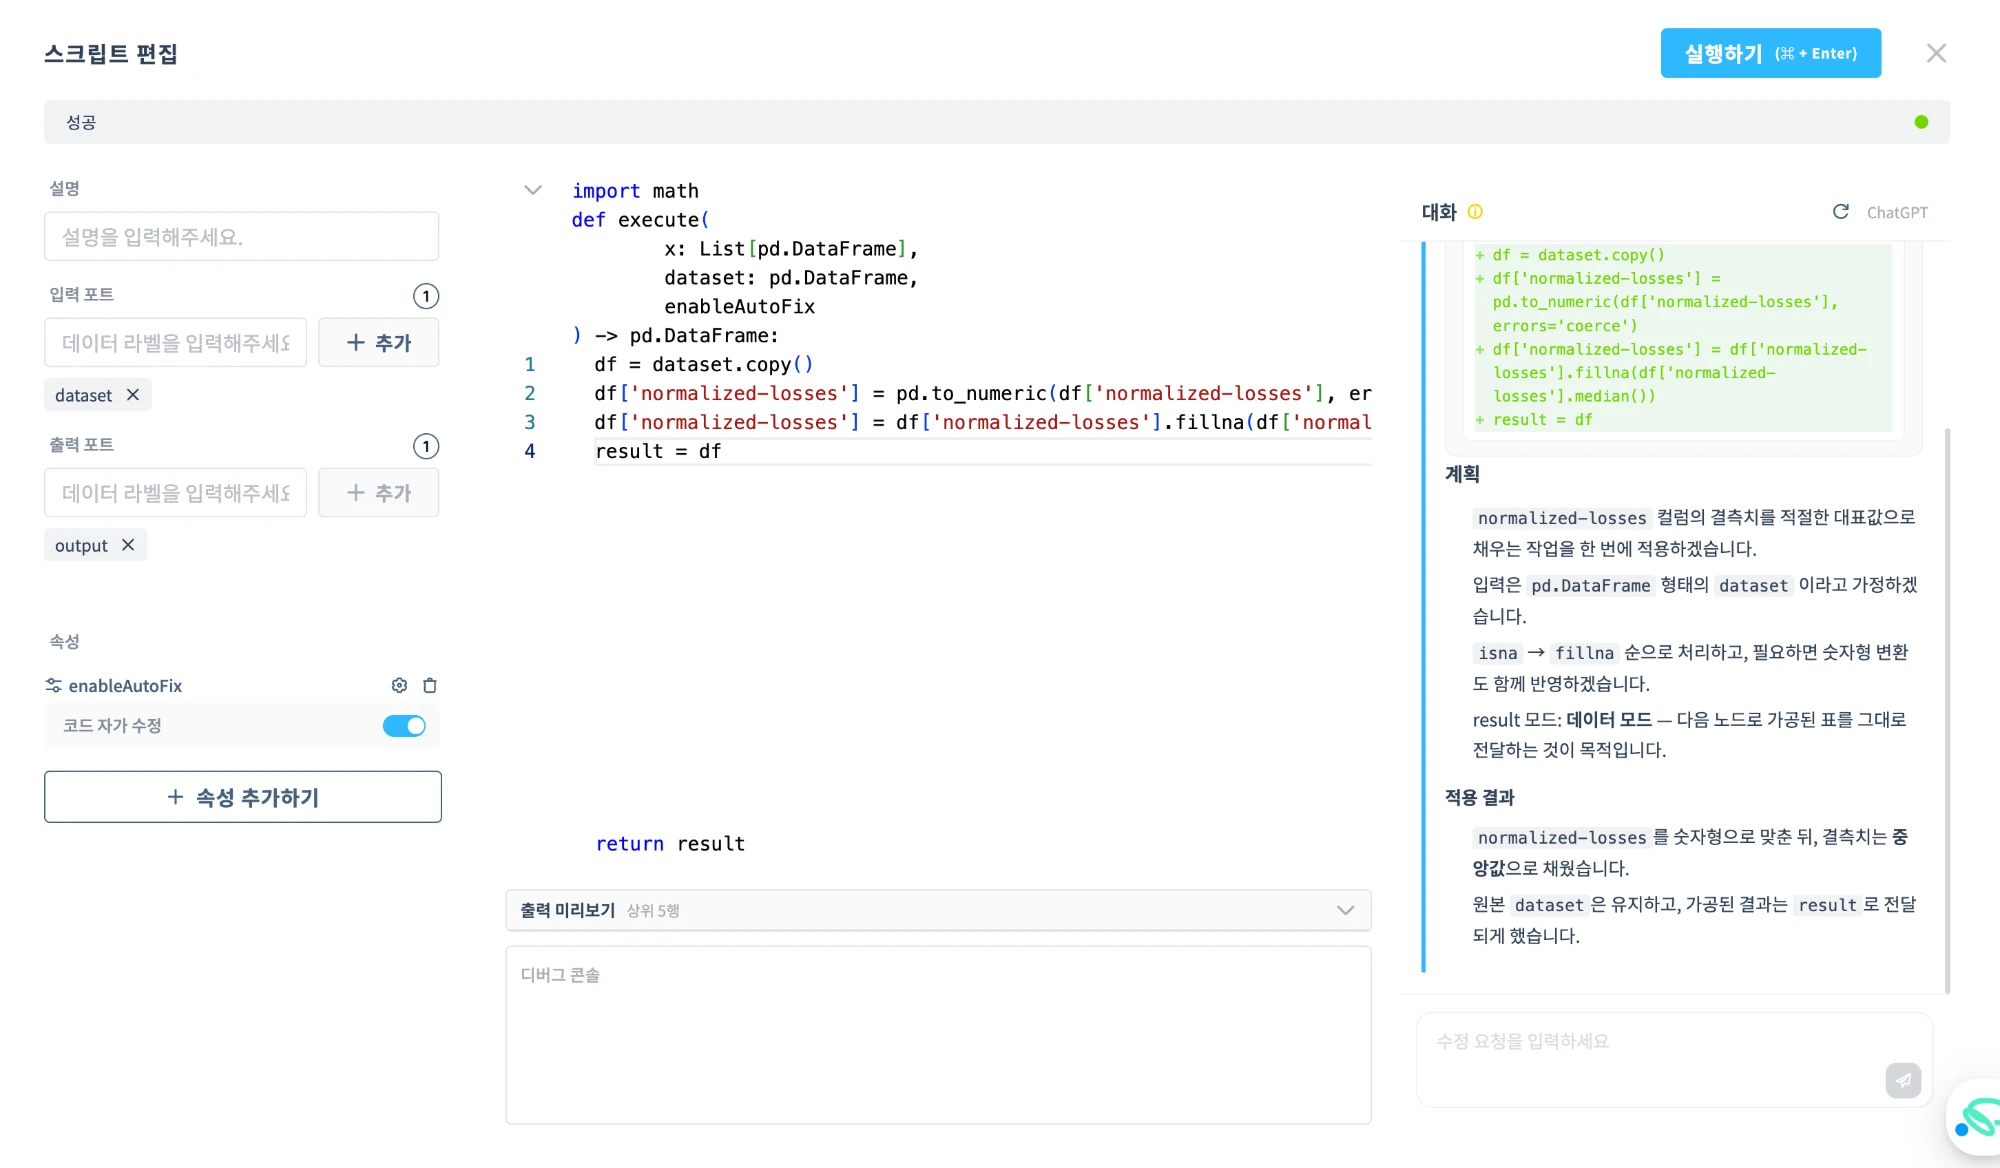
노드를 우클릭한 후 '스크립트 편집'을 선택하면 스크립트 편집 화면이 열립니다.
스크립트 작성법
스크립트는 격리된 샌드박스 환경에서 실행됩니다. 입력 데이터를 미리 정의된 변수로 받아 처리한 뒤, 결과를 result 변수에 대입하는 방식으로 동작합니다.
1. 입력 데이터 접근
입력 포트로 들어온 데이터는 다음 두 가지 방법으로 접근할 수 있습니다.
x리스트: 모든 입력이 순서대로 담긴 리스트입니다. 첫 번째 입력은x[0], 두 번째 입력은x[1]로 참조합니다.- 포트 라벨 변수: 입력 포트의 라벨과 동일한 이름의 변수로도 접근할 수 있습니다. 첫 번째 입력 포트의 기본 변수명은
dataset입니다(dataset은x[0]과 같습니다). AI 코드 어시스턴트도 이dataset변수를 사용합니다.
# 첫 번째 입력 데이터셋의 결측치 제거 (dataset == x[0])
result = dataset.dropna()
pd(pandas)와 np(numpy)는 별도 import 없이 바로 사용할 수 있습니다. (아래 사용 가능한 라이브러리 참고)
일반 데이터 vs 파일 입력
입력의 종류에 따라 변수에 담기는 값의 형태가 달라집니다.
- 일반 데이터셋 — 변수가
pd.DataFrame입니다. (예: 전처리 노드의 출력) - 파일 입력 — 변수가 파일 접근자(dict 형태)가 됩니다. 키는 파일명, 값은 파싱된 객체입니다.
# 파일 접근자 — 키=파일명, 값=파싱된 객체
# csv  → pd.DataFrame      txt  → str            json → dict/list
# xlsx → openpyxl Workbook pptx → Presentation   pdf  → PdfReader
# docx → Document          hwpx → HwpxDocument   ppt  → OleFileIO (구형 ppt, OLE2 컨테이너)
# xls  → xlrd Book (구형 xls)  hwp  → str (본문 텍스트)  rtf  → str (본문 텍스트)
for file_name, obj in dataset.items():
    ...
파싱 옵션이 필요하거나 다른 형태로 다시 열고 싶으면 같은 파일명으로 동사 메서드를 호출합니다. (파일 본문은 1회만 내려받아 캐시되므로 중복 다운로드가 없습니다.)
| 동사 | 반환 | 비고 |
|---|---|---|
dataset.csv(name, sep=";", encoding="cp949") | pd.DataFrame | 구분자·인코딩 등 pd.read_csv 옵션 |
dataset.excel(name, sheet_name=None) | DataFrame / dict | pd.read_excel 옵션 |
dataset.workbook(name, data_only=True) | openpyxl Workbook | 수식의 계산값 등 |
dataset.text(name, encoding="cp949") | str | 원문 문자열 (기본 utf-8) |
dataset.pdf(name) / dataset.docx(name) / dataset.presentation(name) | 파서 객체 | 라이브러리 옵션 그대로 전달 |
dataset.hwpx(name) | HwpxDocument | ⚠️ open( 토큰이 차단되므로 반드시 이 동사 사용 |
dataset.xls(name) | xlrd Book | 구형 .xls(BIFF8). openpyxl Workbook 이 아닙니다 |
dataset.ppt_text(name) | str | 구형 .ppt 본문 텍스트 (슬라이드 순서는 보장하지 않음) |
dataset.hwp(name) | str | 구형 .hwp(HWP 5.0) 본문 텍스트. 표는 <표>, 그림은 <그림> 으로 대체됩니다 |
dataset.rtf(name, encoding="cp949") | str | .rtf 본문 텍스트 (서식 제거) |
dataset.ole(name) | olefile.OleFileIO | 구형 .ppt(OLE2 컨테이너). ole.openstream("PowerPoint Document").read() 로 본문 스트림 bytes — 슬라이드/도형 API 는 없고 record 해석은 직접 |
dataset.path(name) / dataset.ext(name) | 스토리지 키 / 확장자 |
파일 입력으로 자동 파싱되는 확장자는 .csv .json .pptx .pdf .xlsx .docx .hwpx .txt .ppt .xls .hwp .rtf 입니다.
구형 바이너리 형식 중 .ppt 와 .xls 는 지원합니다. 다만 모던 포맷처럼 편한 객체가 아닙니다 —
.ppt 는 OLE2 컨테이너(OleFileIO), .xls 는 xlrd Book 으로 들어옵니다. 본문 텍스트만 필요하면
dataset.ppt_text(name) · xls_text 를 쓰는 편이 간단합니다.
.doc 는 지원하지 않습니다 — 파싱에 외부 변환 엔진이 필요하므로 .docx 로 저장해 전달해야 합니다.
.hwp(HWP 5.0) 와 .rtf 도 파일 입력으로 파싱됩니다 — 다만 파서 객체가 아니라 본문 텍스트 str 로 들어옵니다.
옵션이 필요하면 dataset.hwp(name) · dataset.rtf(name) 동사를, 직접 가진 바이트·문자열에는
hwp5_text · rtf_to_text 를 쓰세요.
그리고 스캔한 이미지 PDF 처럼 텍스트 레이어가 없는 문서는 형식과 무관하게 글자를 읽을 수 없습니다(OCR 미지원).
# 여러 확장자가 섞여 들어올 수 있는 경우 — 확장자로 분기
rows = []
for file_name in dataset:
    ext = dataset.ext(file_name)
    if ext == ".xlsx":
        wb = dataset.workbook(file_name, data_only=True)   # 계산값으로 열기
        ...
    elif ext == ".pdf":
        reader = dataset.pdf(file_name)
        ...
result = pd.DataFrame(rows)
2. 결과 반환
처리 결과는 반드시 result 변수에 대입해야 합니다. return 문은 사용할 수 없습니다. result 에 어떤 타입을 대입하느냐에 따라 노드의 동작 모드가 달라집니다.
pd.DataFrame또는pd.Series→ 데이터 처리 모드: 대입한 값이 출력 포트의 데이터셋이 됩니다. (Series 는 자동으로 DataFrame 으로 변환됩니다)dict→ 파일 저장 모드:{"파일명.확장자": 객체}형태로 대입하면 해당 객체를 파일로 변환·저장하고, 출력 포트에는file_name·file_path두 컬럼의 DataFrame 이 전달됩니다. (.docx,.xlsx,.pptx,.pdf,.hwpx,.csv,.txt,.json지원)
.hwp .doc .xls .ppt .rtf)은 새로 만들 수 없습니다PSE 에 이 형식들의 쓰기 라이브러리가 없습니다. 저장 모드에서 이 확장자들은 bytes 만 받으며,
용도는 base64 로 받은 첨부를 원본 파일 그대로 되돌리는 것입니다.
raw = base64.b64decode(b64_string)
result = {"원본.hwp": raw}        # bytes 만 허용 — HwpxDocument 같은 객체는 거부됩니다
한글 문서를 새로 만들려면 .hwpx 를 쓰세요(HwpxDocument.new()). 구형 .hwp 로는 생성할 수 없습니다.
마찬가지로 워드는 .doc 이 아니라 .docx 입니다.
.pdf 도 객체가 아니라 bytes 를 받습니다 — PdfWriter 로 쓴 뒤 buf.getvalue() 를 넘기세요.
pypdf 는 병합·분할·회전용이라 백지에서 글자가 있는 PDF 를 만드는 것은 불가능합니다.
# 데이터 처리 모드
result = dataset.groupby("region")["sales"].sum().reset_index()
입력 데이터로 문서 만들기 (파일 저장 모드)
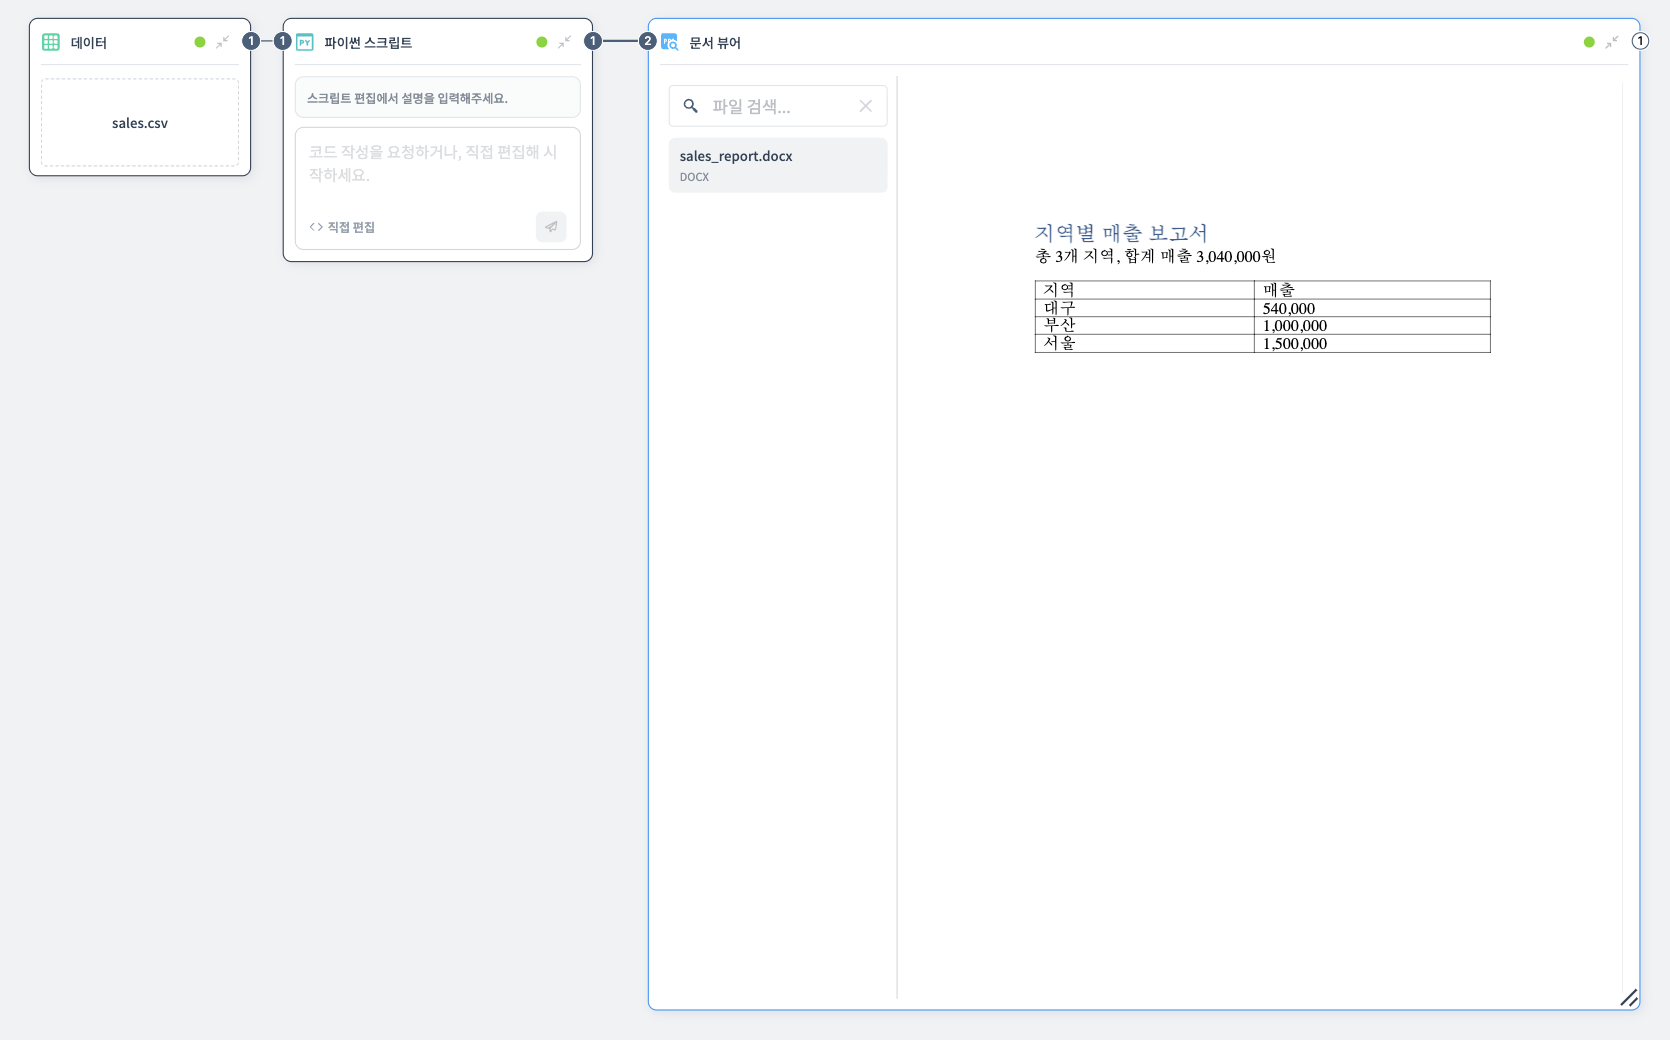
입력 데이터셋을 집계해 Word 보고서로 내보내는 예시입니다. 표를 그대로 문서 표로 옮깁니다.
# 지역별 매출 합계를 구해 Word 보고서로 생성
summary = dataset.groupby("region")["sales"].sum().reset_index()

doc = Document()
doc.add_heading("지역별 매출 보고서", level=1)
doc.add_paragraph(f"총 {len(summary)}개 지역, 합계 매출 {int(summary['sales'].sum()):,}원")

table = doc.add_table(rows=1, cols=2)
table.style = "Table Grid"
hdr = table.rows[0].cells
hdr[0].text, hdr[1].text = "지역", "매출"
for _, row in summary.iterrows():
    cells = table.add_row().cells
    cells[0].text = str(row["region"])
    cells[1].text = f"{int(row['sales']):,}"

result = {"sales_report.docx": doc}   # dict → 파일 저장 모드
엑셀로 내보내려면 openpyxl 의 Workbook 을 같은 방식으로 사용합니다.
# 같은 집계를 Excel 파일로
summary = dataset.groupby("region")["sales"].sum().reset_index()

wb = Workbook()
ws = wb.active
ws.title = "매출"
ws.append(["지역", "매출"])
for _, row in summary.iterrows():
    ws.append([row["region"], int(row["sales"])])

result = {"sales_report.xlsx": wb}
파일 저장 모드의 출력 데이터셋은 file_name·file_path 두 컬럼을 가진 표입니다. 생성된 파일은 PDF 뷰어 등 후속 노드에서 활용하거나 다운로드할 수 있습니다.
3. 사용 가능한 라이브러리
다음 라이브러리·객체는 import 없이 바로 사용할 수 있도록 미리 주입되어 있습니다.
| 분류 | 사용 가능한 이름 |
|---|---|
| 데이터 | pd(pandas), np(numpy), sklearn |
| 표준 | math, random, datetime, collections, itertools, json, re, csv, ast, io, base64 |
| DB 커넥터 | pyodbc, oracledb, mariadb, psycopg2 |
| 문서 생성·읽기 | Document(docx), Presentation(pptx) 및 Inches/Pt/Cm/Emu, Workbook(openpyxl), PdfReader/PdfWriter(pypdf), HwpxDocument(hwpx), olefile(OLE2 컨테이너) |
| 텍스트 추출 | hwp5_text(hwp), rtf_to_text(rtf), ppt_text(구형 ppt), xls_text(구형 xls), xls_workbook(구형 xls → xlrd Book) |
문서 라이브러리는 생성과 읽기 양쪽에 씁니다. 인자 없이 만들면 새 문서가 되고, 바이트를 넘기면 기존 문서를 엽니다.
doc = Document()                    # 새 docx 생성
doc = Document(io.BytesIO(data))    # 기존 docx 읽기
text = "\n".join(p.text for p in doc.paragraphs)
주입된 Workbook 은 생성 전용입니다. 기존 xlsx 를 읽으려면 load_workbook 을 import 해야 합니다. 큰 파일은 read_only=True 가 훨씬 빠릅니다.
from openpyxl import load_workbook
wb = load_workbook(io.BytesIO(data), data_only=True, read_only=True)
아래 함수들은 바이트·문자열을 직접 들고 있을 때 텍스트만 뽑습니다
(파일 입력으로 들어온 .ppt/.xls 는 dataset.ppt_text(name) · dataset.xls(name) 동사가 더 간단합니다).
| 함수 | 입력 | 반환 |
|---|---|---|
hwp5_text(data) | .hwp 파일의 bytes | 본문 텍스트 str |
rtf_to_text(text) | .rtf 파일 내용 str | 서식을 걷어낸 텍스트 str |
ppt_text(data) | 구형 .ppt 파일의 bytes | 본문 텍스트 str |
xls_text(data, sep="\t") | 구형 .xls 파일의 bytes | 시트별 텍스트 str (# 시트명 머리줄 + 탭 구분) |
xls_workbook(data) | 구형 .xls 파일의 bytes | xlrd Book (book.sheets() · sheet.cell_value(r, c)) |
if ext == ".hwp":
    content = hwp5_text(raw_bytes)
elif ext == ".rtf":
    content = rtf_to_text(raw_bytes.decode("utf-8", "replace"))
hwp5_text 는 HWP 5.0 형식을 지원하며, 표 안의 내용은 추출되지 않고 <표> 로, 그림은 <그림> 으로 표시됩니다.
.hwpx 는 이 함수가 아니라 HwpxDocument 를 사용하세요.
4. 제약 사항 (샌드박스)
보안을 위해 스크립트 실행은 제한된 환경에서 이루어집니다.
- 평문
import전면 금지:import os처럼 모듈을 직접 import 할 수 없습니다. 위 표의 미리 주입된 이름만 사용하세요. (from X import Y도 허용 목록에 한해서만 가능) return/yield사용 불가: 주석이나 변수명에return·yield문자열이 포함돼도 차단됩니다. 결과는result변수 대입으로만 전달합니다.- 파일 시스템 직접 접근 불가:
open()으로 파일을 직접 열 수 없습니다. 파일 출력은 위의 파일 저장 모드(dict 반환) 로만 가능합니다. exec/eval/compile금지 (ast.literal_eval은 허용),getattr/setattr/vars/dir등 일부 내장 함수 사용 불가.bytes내장 미제공: 바이트 변환이 필요하면"문자열".encode("utf-8")을 사용하세요.
5. 속성 값 참조
아래 속성 에서 정의한 사용자 정의 속성은, 설정한 변수명 그대로 스크립트 안에서 참조할 수 있습니다.
# 속성에서 변수명을 threshold 로 정의한 경우
result = dataset[dataset["score"] >= threshold]
설정
1. 설명
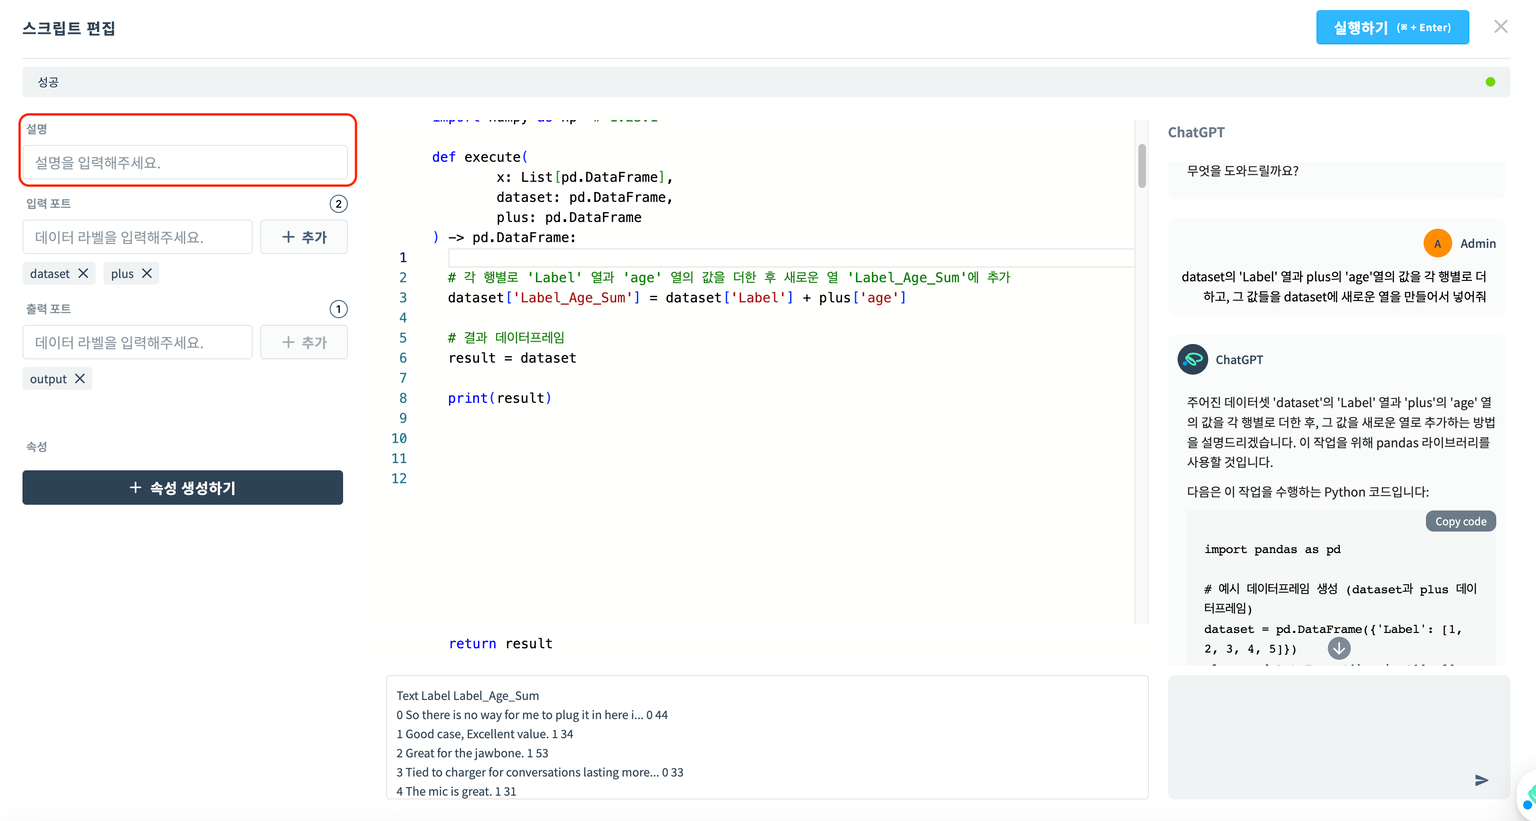
파이썬 스크립트 노드에 대한 설명을 추가합니다. 캔버스에서 노드에 설명이 표시됩니다.
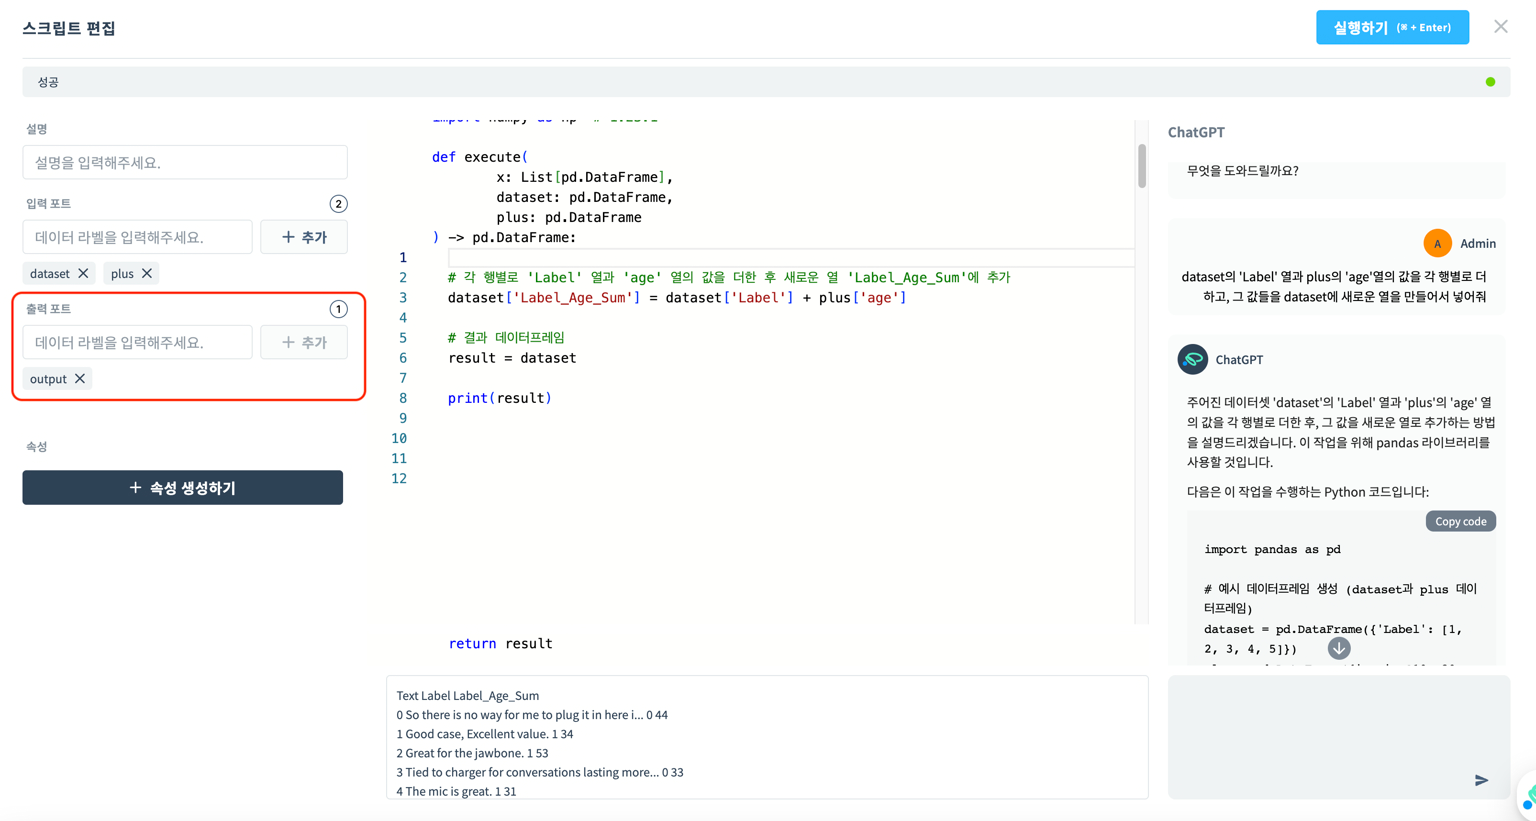
2. 입력 포트
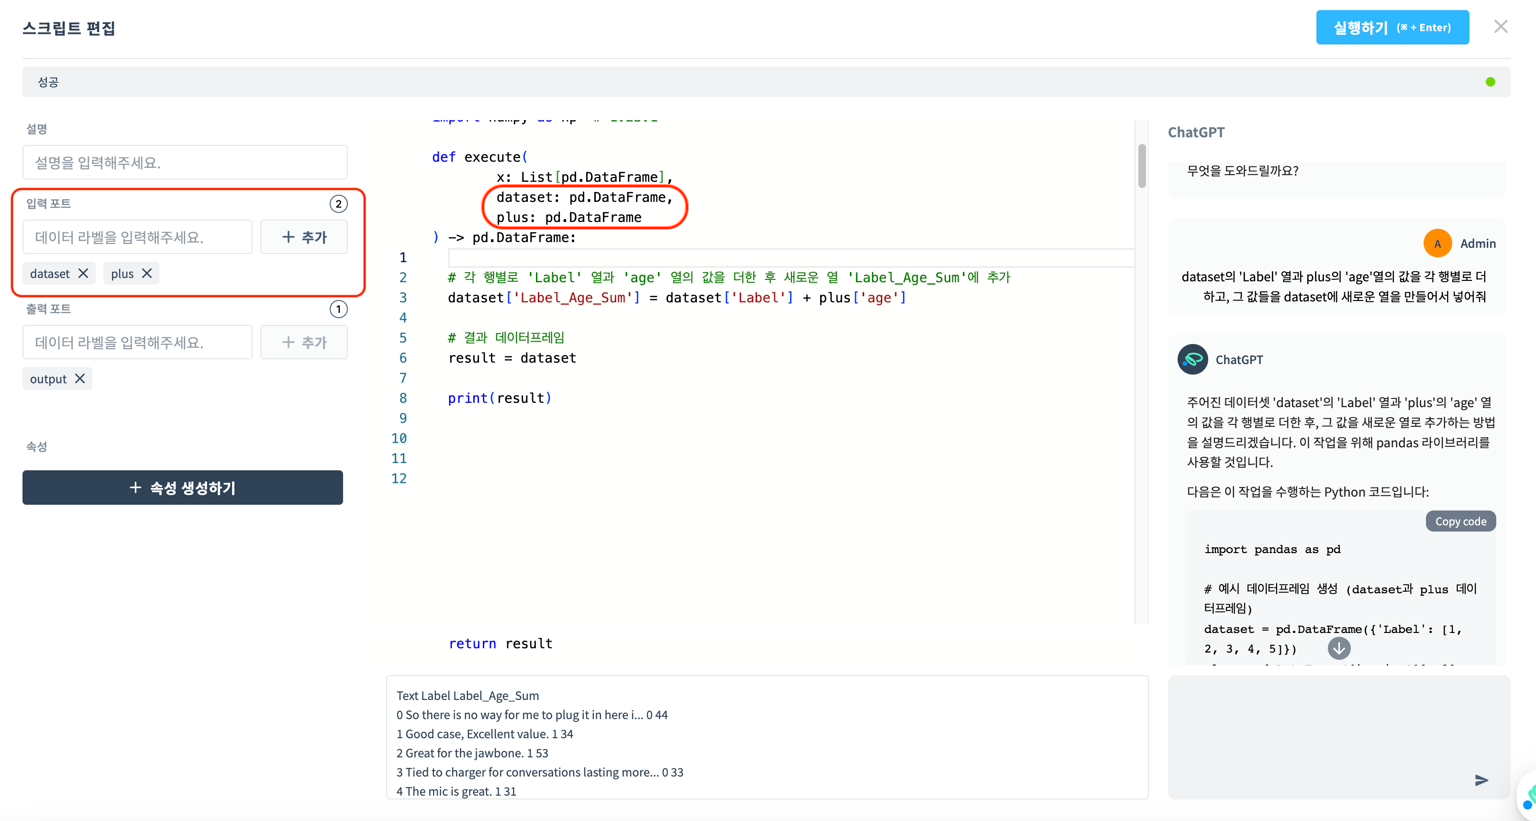
데이터셋 입력 포트를 동적으로 추가할 수 있습니다.
3. 출력 포트
출력 포트는 최대 1개만 생성할 수 있습니다.
포트의 라벨을 변경하려면, 기존 포트를 삭제한 후 새로 생성해야 합니다.
4. 속성
사용자 정의 속성을 생성할 수 있습니다.
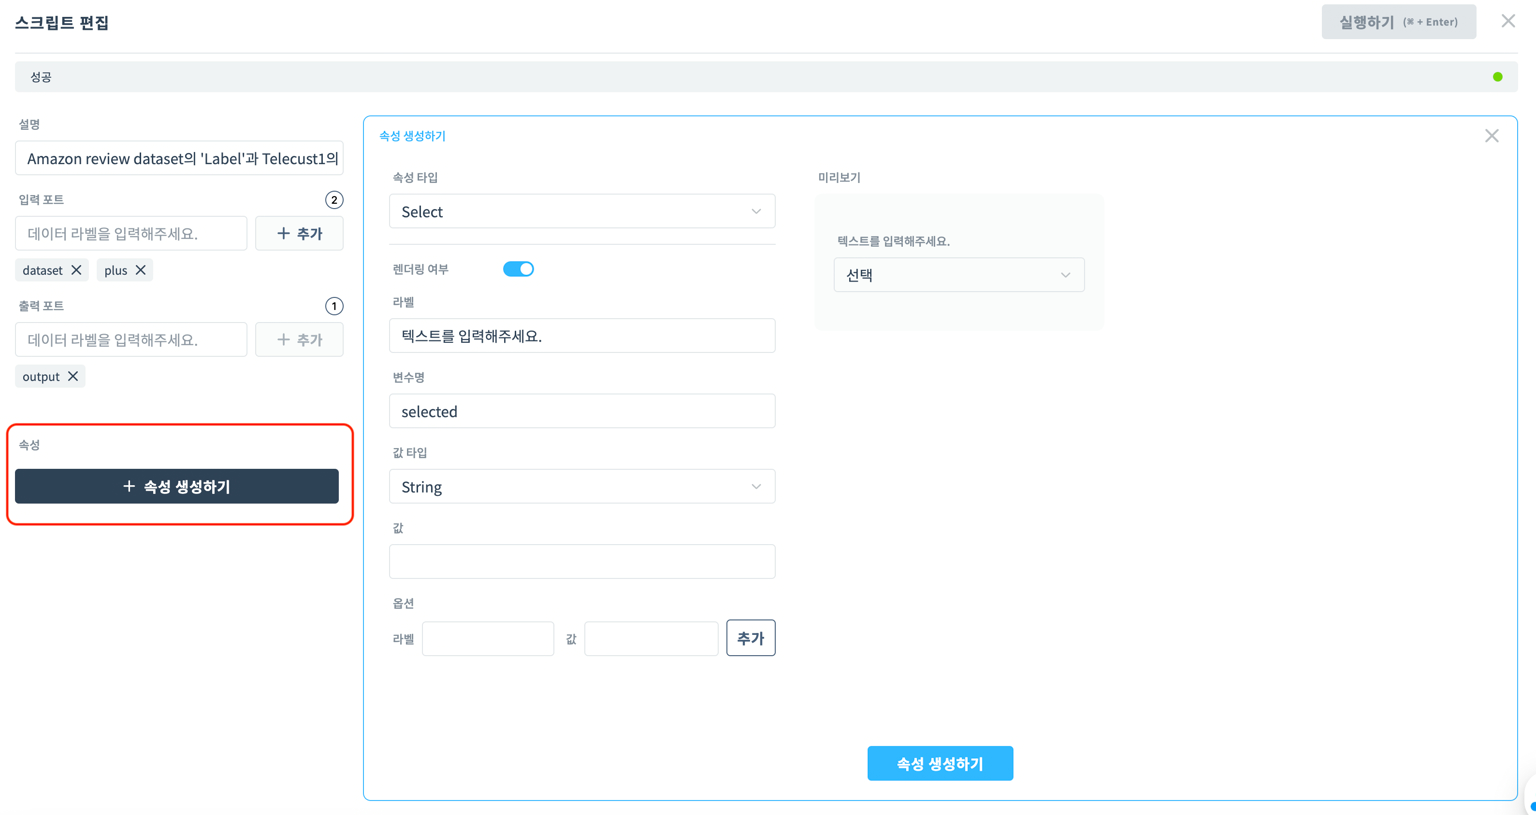
4-1. 속성 세부 설정
속성 탭에 표시:
노드의 속성 탭에 해당 속성을 표시할지 선택할 수 있습니다.
라벨:
속성의 라벨을 설정할 수 있습니다.
변수명:
Python 코드에서 사용할 변수명을 설정합니다. 여기서 설정한 변수명으로 코드 내에서 해당 속성 값을 참조할 수 있습니다.
값:
변수의 초기화 값을 설정할 수 있습니다. 속성 타입에 따라 설정할 수 있는 초기 값의 타입이 다를 수 있습니다.
4-2. 속성 타입
Input:
사용자가 값을 직접 입력하는 속성을 추가합니다.
Select:
드롭다운 방식으로 값을 선택하는 속성을 추가합니다.
- 값 타입: 값 타입을 String 또는 Number로 설정할 수 있습니다
- 옵션: Select할 값과 값의 라벨을 추가할 수 있습니다
Num Count:
클릭으로 숫자 값을 조정하는 속성을 추가합니다.
- Options: 조정 값의 범위를 설정합니다
- min: 범위의 최솟값
- max: 범위의 최댓값
- step: 한 클릭당 조정되는 값의 정도
Slider:
슬라이더 방식으로 값을 조정하는 속성을 추가합니다.
- Options: 조정 값의 범위를 설정합니다
- min: 범위의 최솟값
- max: 범위의 최댓값
- step: 슬라이더 한 칸당 조정되는 값의 정도
Boolean:
True 또는 False 값을 가지는 속성을 추가합니다.
- 값: 토글이 켜져있으면 True, 꺼져있으면 False를 가집니다
AI 코드 어시스턴트
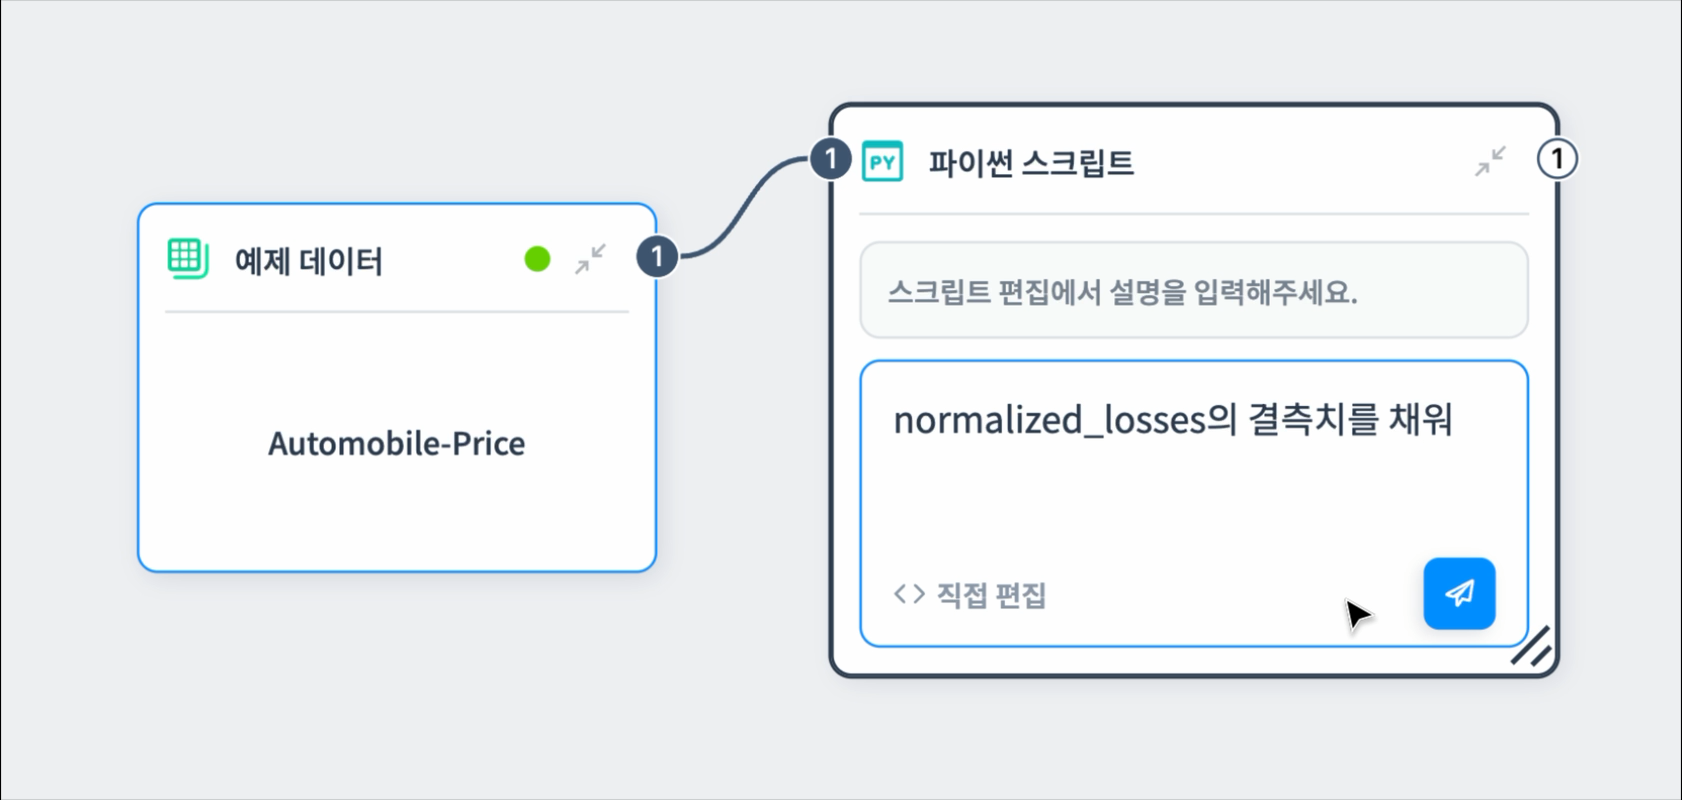
파이썬 스크립트 노드에는 자연어 요청으로 코드를 작성·수정해 주는 AI 코드 어시스턴트가 내장되어 있습니다. 직접 Python 을 작성하지 않아도, "매출을 지역별로 합계 내줘", "결측치가 있는 행을 제거해줘" 처럼 한국어로 요청하면 위의 스크립트 작성법 규칙(입력 변수 dataset·result 반환·샌드박스 제약·파일 분기)에 맞는 코드를 만들어 줍니다.
두 곳에서 사용할 수 있습니다.
- 노드 본체 — 편집 화면을 열지 않고 노드에서 바로 요청을 입력할 수 있습니다.
- 스크립트 편집 화면 — 오른쪽 채팅 패널에서 코드를 보며 대화할 수 있습니다.
동작 방식
- 계획 → 코드 — 요청을 받으면 AI 가 먼저 무엇을 어떻게 처리할지 계획을 세운 뒤, 그에 맞는 코드를 생성합니다.
- 자동 실행 — 코드가 변경되는 요청이면, 생성·수정된 코드를 노드에 반영하고 자동으로 실행합니다. (코드 변경이 없는 단순 질문은 실행하지 않습니다.)
- 자가 수정(auto-fix) — 자동 실행이 실패하면 AI 가 그 오류 메시지를 받아 코드를 스스로 고치고 다시 실행합니다. 성공하거나 최대 5회에 도달할 때까지 반복합니다.
AI 코드 어시스턴트 요청은 호출 1회당 크레딧이 소모됩니다. 자가 수정이 여러 번 반복되면 그만큼 호출이 늘어날 수 있습니다.